2026 THJCC CTF Summer Edition:網管組 Writeup
2026 THJCC CTF Summer Edition | Network Team
Date: 2026/08/15
Role: CTF Network Admin Lead
前言
上一次參加 THJCC 網管組已經是第三屆的事情了。
那時候的我基本上就是一個水著身份組的組員,比賽結束之後甚至有種「蛤?所以剛剛到底發生了什麼,比賽怎麼就結束了 ww」的感覺。
結果一年後不知道為什麼,就變成網管組長了。
先簡單自我介紹一下,我是 Kaiyasi,目前就讀中興大學應用數學系一年級,同時擔任 SCAICT 中部高中電資社團聯合會議 資訊組長。平常比較常碰全端開發、系統架構、Linux 和一些資安相關的東西。
比賽結束後,總召丟了一個任務給我:寫一篇賽後 Writeup。
但網管組又沒什麼 Flag 可以 Write,所以這篇跟一般的 CTF Writeup 不太一樣。比起解題,我比較想記錄這次到底怎麼把整個比賽環境架起來,以及從賽前、賽中一路到賽後,網管到底都在做什麼的介紹。
賽前比賽環境建置
1. 窮學生的救星:感謝國雲網路
辦學生競賽有一個非常現實的問題:
機器哪裡來?
CTFd 要一台、題目環境要機器,有些題目還會需要額外的 CPU、記憶體或獨立服務。全部自己租的話,比賽還沒開始,經費大概就先沒了。
這次 2026 THJCC Summer Edition 的伺服器資源由 國雲網路 NCSE Network 的社群贊助計畫提供,包含 VPS 與網路資源。
這點真的幫了我們非常多。
至少網管不用在籌備期間一邊算 CPU 和 RAM,一邊看著 VPS 價格思考自己這個月還能不能吃飯。
如果是高中、大學資訊社團、開源專案,或其他學生技術活動,有類似的主機需求,也可以去看看他們的社群贊助計畫。
2. 所以到底要申請多少資源?
有贊助歸有贊助,也不可能直接跟人家說:
給我最頂的,越多越好。
所以賽前第一件麻煩事,就是估算資源。
理想狀況下,可以大概寫成:
我們主要會看幾件事情。
-
CTFd 本身需要多少資源
參賽人數大概多少、開賽瞬間會有多少人一起登入、刷新題目、提交 Flag。 -
題目環境吃多少資源
Misc、Crypto 這類題目可能只是提供檔案,但 Web、Pwn 或需要動態 Instance 的題目,資源需求就完全不一樣。 -
一定要留 Buffer
資源如果估到剛剛好,通常就是準備出事。實際上會額外留大概 20%~30% 的空間,至少遇到瞬間流量或某題突然吃資源時還有地方可以撐。
聽起來很合理。
問題是——
申請主機的時候,題目大概率根本還沒出完。
這大概也是辦 CTF 的固定劇情。距離比賽還有一段時間時,題目表可能一半都是空的;等接近死線,大家才開始瘋狂交題。
所以你根本不可能精準知道最後會有幾題 Web、幾題 Pwn,又有哪一題會突然冒出一個超級吃 RAM 的服務。
最後還是只能參考往年參賽人數、題目數量和以前的資源使用狀況,先抓一個大概的區間。
好在國雲這次在資源配置上滿有彈性的,不需要一開始就把所有規格完全定死。
我們採用的方式是先把基本環境架起來,確保 CTFd 和主要題目服務有足夠資源;等出題進度比較完整之後,再根據實際題目需求調整配額。
不然前期真的只能通靈。
3. CTFd 跟靶機不要塞在一起
在規劃架構時,很容易出現一個看起來很省事的想法:
一台大機器,把 CTFd 跟所有題目 Docker 全塞進去不就好了?
理論上可以。
但實務上不會這樣幹。
這次我們直接把環境拆成兩類:
- CTFd 平台主機
- 題目靶機主機
最直接的原因就是 不要讓題目把平台一起拖下水。
CTF 選手在解題時會做什麼大家都知道。爆破、多執行緒腳本、大量 Request、奇怪 Payload,甚至不小心讓某個服務卡死,全部都很正常。
假設某一題突然 OOM,或者 CPU 被打到 100%,如果 CTFd 剛好跟它住在同一台機器上,那就不是「一題掛了」,而是整個 Scoreboard 跟著一起掛。
然後所有人都不能交 Flag。
Discord 大概十秒後就會開始:
平台是不是死了
502
我這邊也 502
admin???
另外一個問題是隔離。
CTF 靶機本來就是故意放漏洞給選手打的,有些題目的目標甚至直接就是 RCE。就算 Docker 有做隔離,也沒必要把充滿漏洞的 Challenge Environment 跟 CTFd、Database 放在同一個 Host 上增加風險。
所以平台和題目環境分開,本質上就是在縮小影響範圍。

4. CTFd Theme
CTFd 本身很好用,但預設介面大家應該也看得很熟了。
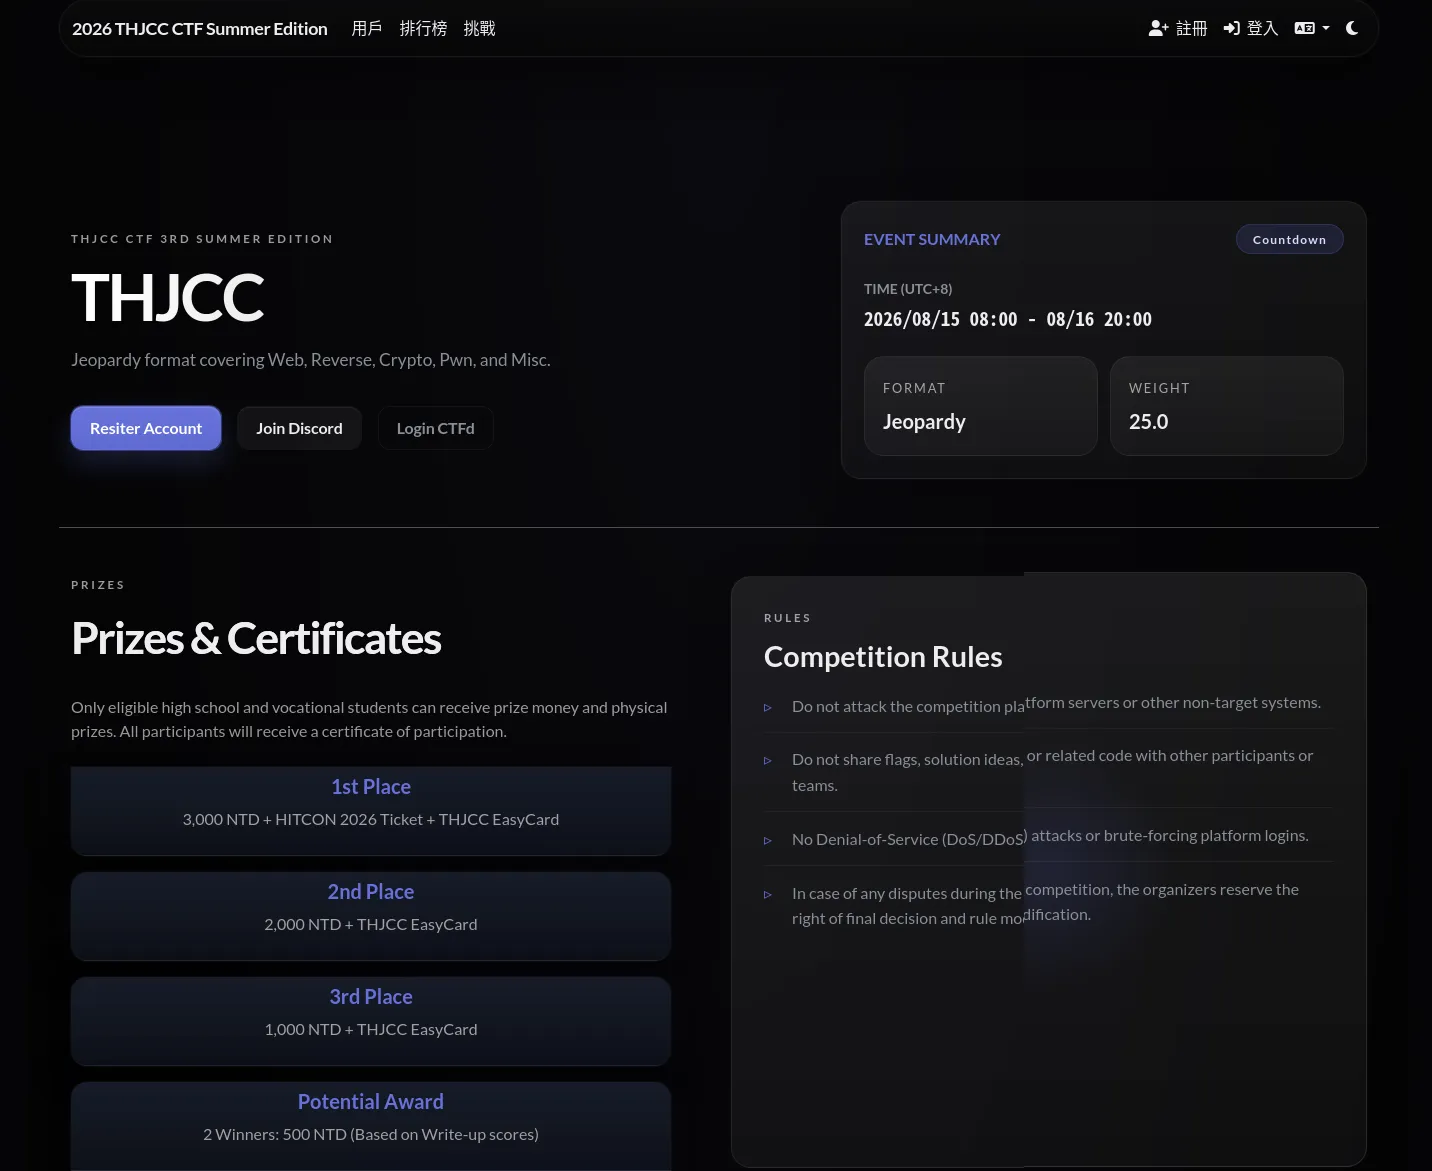
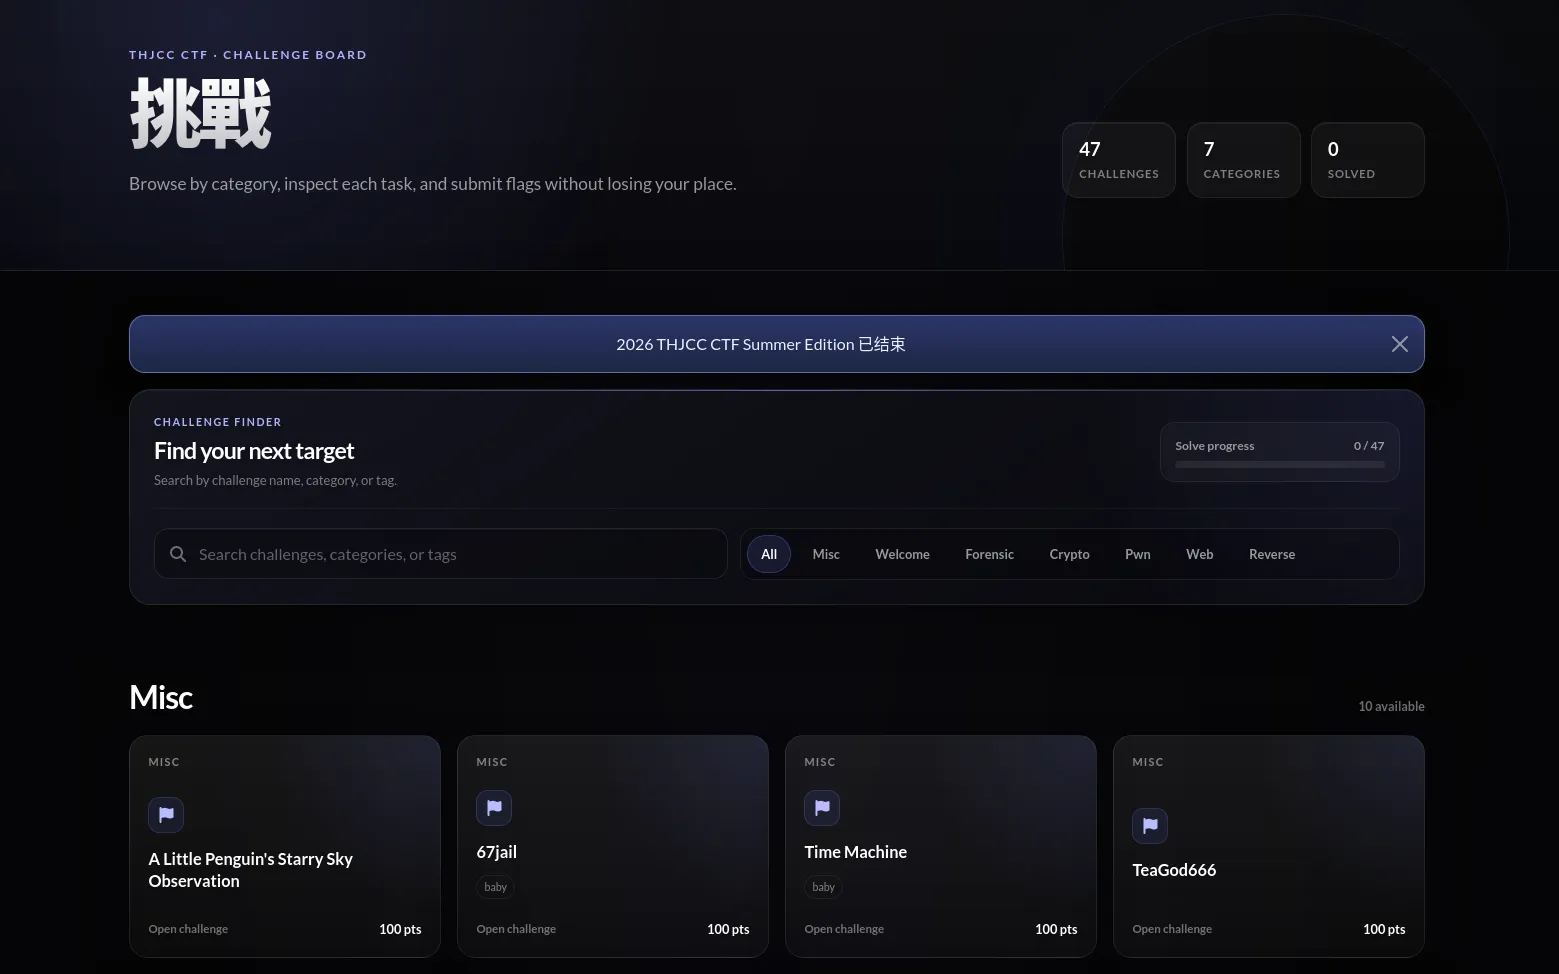
既然 THJCC 有自己的視覺設計,我們這次也有另外做一套 CTFd Theme,讓比賽平台至少不要一打開就長得跟其他 CTF 一模一樣。
主要調整包含:
- THJCC 的整體配色
- 首頁資訊與賽事規則
- 獎金資訊卡片
- Challenge Board
- 題目分類篩選
- Challenge Card 排版
功能上當然還是 CTFd,但整體看起來至少比較有「這是 THJCC 的比賽」的感覺。
5. CTFd 部署時比較容易踩的東西
CTFd 官方本身就有 Docker Compose,所以單純「把它跑起來」其實不難。
難的是你要讓一群人在同一時間一起用它,而且最好不要突然爆炸。
這邊記幾個這次有特別注意的地方。
Nginx Reverse Proxy 與 Rate Limit
登入、提交 Flag 之類的 Endpoint 最好做基本的 Rate Limit。
因為正式開賽之後,你永遠不知道大家手上的腳本會怎麼敲你的 Server。
太寬鬆可能被大量 Request 灌爆,太嚴又可能影響正常玩家,所以還是要根據實際流量調。
Redis
CTFd 本身在多人同時操作的情況下會有不少 Session、快取與背景工作需求。
正式環境把 Redis 配好,可以減少一些不必要的負擔,也比全部事情都直接往 Database 丟來得合理。
Cloudflare
外層我們也有透過 Cloudflare 處理流量。
至少靜態資源可以交給 CDN,另外對一些很基本的掃描或異常流量,也多一層可以擋。
當然,Cloudflare 不是套上去就無敵,該做的 Server-side 防護還是得做。
動態 Challenge 的生命週期
如果題目是「一人一台 Instance」或動態建立 Container,那 Auto Cleanup 一定要測。
不然測試環境大家開一開,幾天後上去 docker ps -a,會發現裡面住著一整個墳場。
正式比賽前 RAM 跟 Disk 被測試 Container 吃光就好笑了。
賽中問題處理與救火現場
比賽一開始之後,網管基本上就進入:
希望今天不要發生奇怪的事情。
然後通常就會發生奇怪的事情。
1. btop:網管的血壓監測器
比賽期間, Terminal 裡幾乎一直開著 btop。
CPU、Memory、Load Average、Process 狀況都可以直接看,出了什麼問題通常也會先從這邊發現。
直到它變成這樣:
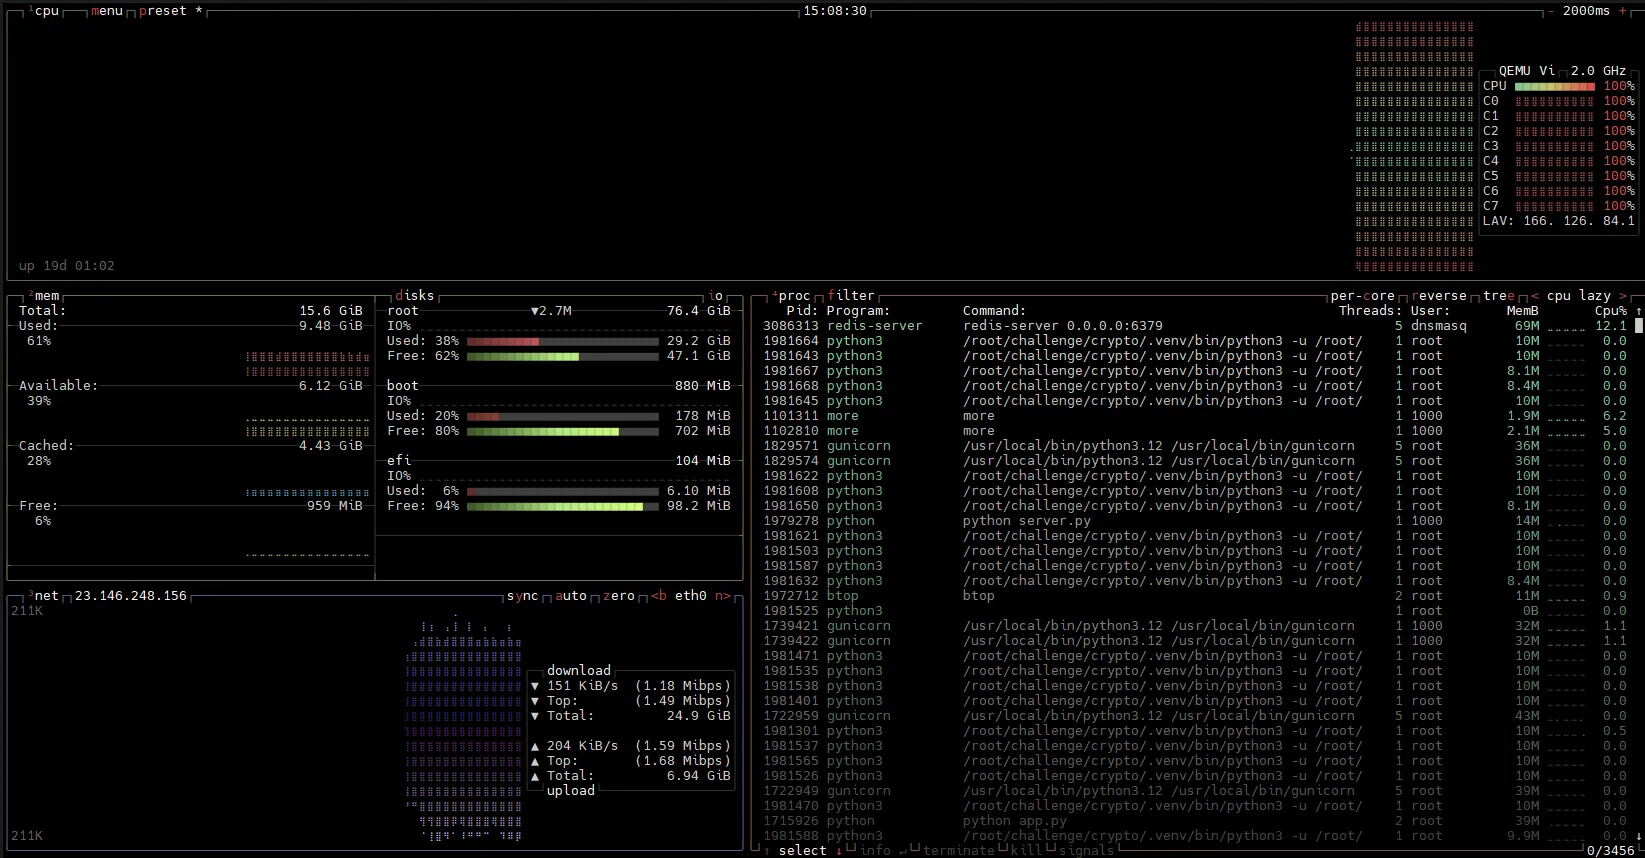
8 個 CPU Core 全滿。
Load Average:
166嗯。
看起來非常健康。
Process List 裡面基本上被某些 Crypto 題目的 Python / Gunicorn Process 塞滿。
看到這個數字時大概就知道今天事情不會少了。
2. 題目 Process 沒有正常回收
後來往下查,發現其中一部分問題來自題目的程式本身。
有些需要計算或另外 Spawn Process 的 Challenge,在 Client 連線之後沒有處理好 Timeout 或 Process Cleanup。
平常只有一兩個人測試時完全看不出來。
正式開賽之後,幾十、幾百個連線一起進來,Process 數量就開始瘋狂往上疊。
最後 CPU 直接滿載。
這時候就只能先處理現場,一邊把異常 Process 清掉,一邊找出題組確認是哪一題、哪段服務出了問題,再調整 Challenge 的啟動方式或限制。
這也是我這次很有感的一件事:
驗題不能只驗 Flag 拿不拿得到。
服務會不會正常結束、連線斷掉之後 Process 有沒有回收、多人同時打會不會炸,這些也都算驗題的一部分。
只是平常最容易漏掉。
3. Port Mapping 靈異事件
另外一類問題就比較單純:
Container 跑了,但玩家連不到。
賽前測試有些題目主要確認本機環境正常,到了正式部署才發現 Port Mapping 寫錯、Entry Point 權限不對,或者 Service 根本沒有正確 Listen 在預期的 Interface 上。
開賽沒多久 Ticket 就開始出現:
這題連不上
然後網管開始:
docker ps
docker logs ...
ss -tulpn
一路往下翻。
最後發現:
喔,Port 寫錯了。
修掉、Restart、測試。
然後回 Ticket:
已修復~
4. 題目被打掛
還有一種情況就是 Challenge 真的被玩家打到 Crash。
這種東西在 CTF 其實沒那麼罕見,尤其當大家開始寫自動化 Script 後,一個原本正常的服務可能突然收到非常密集的 Request。
發現題目下線之後,我們通常會先看:
- Nginx Access Log
- Container Log
- Request Pattern
- Source IP
- 同一來源的 Request Frequency
先判斷到底是正常解題行為觸發 Bug,還是某個 Script 完全沒有 Delay,短時間內狂打 Server。
如果確認某個來源造成明顯異常流量,就先針對來源做 Rate Limit 或 Drop,避免其他玩家也一起受到影響,再回頭處理 Challenge 本身。
有時候你本來只是來維護 CTF。
維護到後面會開始像在做 Incident Response。
賽後資料導出與收尾
比賽倒數歸零之後,選手可以關電腦去睡覺。
網管還不行,還有資料要整理與統計。
1. CTFtime 與比賽資料
這次 THJCC Summer Edition 有登錄在 CTFtime,因此賽後需要整理 Scoreboard 等相關資料。
主要包含:
-
Scoreboard / CTFtime Feed
整理隊伍名稱、分數、排名等資訊,供後續成績處理。 -
Submission Logs
保留 Flag Submission、時間等紀錄。除了之後分析比賽狀況之外,如果需要調查異常提交,也會用到這些資料。 -
CTFd Database 與 Challenge Environment
比賽結束後把 CTFd Database、題目設定和相關部署資料備份下來。
這些東西當下看起來可能只是「比賽結束記得打包」,但之後要做復盤或下一屆交接時非常有用。
不然一年後問:
去年這題到底怎麼 Deploy 的?
大家一起失憶。
網管組長心得
從第三屆那個比賽結束後連比賽都過了還不知道的網管組員,到今年直接接網管組長,差距其實滿大的。
以前參賽時注意的是題目能不能解、Flag 能不能交。
當網管之後看的東西變成:
CPU
RAM
Load Average
Container
Nginx Log
Port
Ticket
然後祈禱不要再多一個東西亮紅燈。
另外像是 Challenge Port 配錯、Container 掛掉、Process 沒有回收、玩家 Script 把服務打爆,這些問題其實單獨來看都不是什麼超級困難的技術問題。
麻煩的是它們會在正式比賽進行中的時候發生。
你沒有幾個小時可以慢慢 Debug,只能先把服務救回來,再去追真正的 Root Cause。
這大概也是這次最大的收穫。
以前做自己的 Server,炸了大不了自己晚點修。
但比賽環境不一樣。
你的每一次 Restart、每一條 Firewall Rule、每一次設定修改,後面都是正在比賽的玩家。
所以除了「會架 Server」之外,怎麼降低修改的影響、怎麼快速定位問題,以及怎麼在一堆 Ticket 同時進來時判斷哪件事情最急,反而才是比較難的部分。
另外再次感謝 國雲網路 NCSE Network 提供這次比賽所需要的 VPS 與網路資源。
總之,2026 THJCC CTF Summer Edition,網管存活。
下次看到 Load Average 166 的時候,希望不是在 THJCC 上。
2026 THJCC CTF Summer Edition: Practical Writeup as Network Admin Lead
2026 THJCC CTF Summer Edition | Network Team
Date: 2026/08/15
Role: CTF Network Admin Lead (Network Admin Team Leader)
Introduction
Looking back on my time as a network admin for the third THJCC CTF, I was in a state of complete confusion—like I didn’t even know what had just happened, and the competition ended without warning. I never expected that, after a year, I would be promoted to the role of “Network Admin Team Leader” by sheer chance.
Before diving into the main content, let me briefly introduce myself: I’m Kaiyasi, a freshman in the Department of Applied Mathematics at National Chung Hsing University. I also serve as the Information Department Head of SCAICT (Southern and Central High School Information Club Alliance). My interests and learning focus mainly revolve around full-stack web development, system architecture planning, and practical exploration in the field of information security.
After this competition, I was entrusted with a post-event task by the general coordinator, and I decided to write this rather unconventional “Writeup.” Unlike the usual writeups focused on solving challenges, this article will take a maintenance and infrastructure perspective, discussing “What exactly does a CTF network admin do?” “What major pitfalls and unexpected situations occur during the pre-event, during the event, and after the event?” and how our behind-the-scenes team managed to steadily build and maintain the entire competition’s network and infrastructure.
Pre-Event Setup of the Competition Environment
1. A Student’s Lifesaver: Thanks to NCSE Network
Honestly, anyone who has organized student competitions or club activities knows that the most frustrating part of the preparation phase is not only creating challenges and finding sponsors but also “where to get the servers and machines.” If every server had to be rented on a public cloud, poor students would be forced to eat dirt on the roadside after organizing one competition.
Therefore, I must first express my sincere gratitude to NCSE Network (ncse.tw) for their community sponsorship program! The entire environment for the 2026 THJCC Summer Edition was successfully set up, all thanks to the high-performance VPS servers and stable bandwidth resources generously sponsored by NCSE Network. Whether it’s the quality of network connectivity, the performance of the host, or the technical support, it made our setup behind the scenes much more reassuring. If you have a high school or university information club, an open-source project, or are also organizing similar student competitions, I highly recommend applying for their community sponsorship program. It’s definitely a super big godfather for student teams!
2. Resource Request Time: How to Gracefully Ask Sponsors for Resources?
Although we have sponsor support, we can’t just hand our hands up to our godfather and say, “Just give me the top of the line, the more the better” ww. As the network admin lead, the most important math problem before the event is “resource estimation.” You must calculate a reasonable hardware list based on the expected scale. We generally use the following logic to estimate resources:
In plain terms:
- Basic Platform: How many teams are expected to participate? How many people will be hitting the homepage at the start? This determines the basic CPU and memory requirements for the CTFd platform.
- Resource Consumption of Questions: How many questions did the question team release? Which ones are memory-hungry web services? Which ones are dynamic container-based Pwn questions? Each question must be pre-estimated with a memory and CPU limit.
- Buffer to Prevent Crashes: The engineer’s rule is “Never allocate resources exactly at 100%.” Adding 20% to 30% buffer space can help cope with unexpected traffic and sudden situations at the start of the event.
But reality is often harsher than expected—questions were not even completed before the event!
Everyone who has organized a CTF knows that the question team often has to work under extreme pressure in the last few days before the deadline. At the time we had to submit our resource request to the sponsor, the question list was only half-filled, and the proportion of question types (how many Web/Pwn questions that consume resources and how many static Misc/Crypto questions) was a mystery.
At this point, it’s a real test of the network admin’s “mystical experience.” We had to refer to past events’ participation numbers and question scales, using past experience to infer a reasonable range for estimation.
Even better, NCSE Network’s community sponsorship program is very flexible and doesn’t require you to finalize the resource specifications at the first moment!
This is a lifesaver for network admins. Our strategy was: Initially apply for resources conservatively, ensuring the basic platform and core target machines can run steadily. Once the event approaches and the question team gradually completes the questions, if we find that certain questions are particularly resource-heavy or memory is tight, we can promptly request additional quotas and flexible expansion from NCSE Network. This not only prevents the waste of sponsor resources but also greatly reduces the psychological pressure on network admins during the pre-event guessing of specifications.
3. Architectural Taboo: Why You Must Never Use Just One Machine? (The Philosophy of Separating CTFd and Target Machines)
During meetings discussing the architecture, someone might occasionally say, “Hey, a top-of-the-line machine with CTFd and Docker questions all in one is enough, isn’t centralized management super convenient?”
Hearing this idea, I can only say: Don’t do it, really, it will cause big problems!
This time, we insisted on strictly separating the architecture into two independent servers: one for the CTFd platform and one for the question target machines. There are two major reasons behind this decision:
-
Isolation and Protection from Attacks (Resource Protection):
Everyone knows how brutal CTF players can be. During the solving process, they often write multi-threaded Python scripts for brute-forcing, send various malicious payloads, and create infinite loops. If we put the target machines and CTFd on the same server, if a question is exploited to the point of memory overflow (OOM) or CPU usage hits 100%, the entire server will freeze, and the CTFd platform will directly show a502 Bad Gateway. At this point, no one can submit a flag, and the Discord channel will be flooded with cries of “The platform is down!” within five seconds. The scene is already painful to imagine. -
Security Risks and Internal Network Isolation (Permission Protection):
The target machines are filled with various intentionally designed vulnerabilities, and many questions are even designed to target RCE (Remote Code Execution). If both are on the same machine, and a question’s container is completely exploited and the attacker gains privileges, the attacker can access the internal network of the Docker container and directly steal the database of the CTFd and all the flags of the questions. This would mean the competition could be declared over for everyone.
Therefore, physically or virtually isolating the scoreboard and target machines is the first line of defense for network admins to sleep well.
4. Creating Your Own Identity: Custom CTFd Theme and Visual Design
Although almost all CTF competitions run on the open-source platform CTFd, honestly, if every competition looks the same, it feels like it’s missing a soul.
Each competition has its own unique visual identity and atmosphere. To give participants an immersive experience from the moment they log in, we invested a lot of effort in customizing the CTFd theme (Custom Theme). From the deep, modern color scheme of the event, the display of the event rules and prize cards on the homepage, to the classification filtering and question card layout on the challenge board, the competition is not only stable but also full of a unique technological feel that belongs to THJCC!
5. Small Pitfalls When Setting Up CTFd
After starting the host, the next step is to deploy CTFd. Although the official has a ready-made Docker Compose that can be launched with one click, there are still several details that can cause problems when used in a production environment for hundreds of people:
- Nginx Reverse Proxy and Rate Limiting (Traffic Control):
This is the most important! If you don’t set up rate limiting rules in Nginx, you will see Nginx logs flooding like a waterfall within the first five minutes of the event, and the server will be overwhelmed by automated scanning scripts. Be sure to set appropriate request rate limits on the login and flag submission API endpoints. - Redis Cache and Session Management:
It is strongly recommended to use Redis. At the moment the competition starts, everyone is frantically pressing F5 to refresh the question list. If every request directly accesses the MySQL database, the database connection pool will be filled up instantly. Having Redis help manage hot data caching and sessions will significantly improve the overall response speed. - Cloudflare CDN Protection:
Wrap it with Cloudflare on the outer layer. In addition to helping absorb most of the static resource (CSS, JS, images) traffic, it can also block some basic strange scans and small-scale traffic impacts. - Management of the Lifecycle of Dynamic Questions:
If there are “one team, one entity” dynamic questions this time, be sure to confirm that the automatic timeout and recycling mechanism (Auto Clean-up) is working properly. Otherwise, if you leave a bunch of containers open during testing, you will find that the hard drive and memory are already consumed by a bunch of dead ghost containers before the official start of the event, leaving no space to open new questions.
Problem Handling and Firefighting During the Event
Once the starting whistle blows, the “gut-wrenching time” for the network admin team officially begins. Even if the pre-event testing is perfect, there will always be all kinds of unexpected situations waiting for you after the event starts.
1. Monitoring Tools Emerge: Real-Time btop for Blood Pressure Spikes
Throughout the competition, the tool that is almost always running on the network admin terminal is btop (btop++). This terminal resource monitoring tool based on C++ not only has a great interface but also updates all indicators in real time, making it an essential tool for keeping track of the host’s health status.
However, when you see the following screen, your heartbeat will probably also skyrocket along with the CPU:
Yes, this is the “disaster scene” we actually captured during the event—all 8 CPU cores are fully loaded, red all over, and the Load Average even soared to an astonishing 166! The process list is filled with Python and Gunicorn processes for Crypto questions. At that moment, your palms really will start to sweat.
2. Firefighting Scene (1): Question Code “Leaking,” Resources Being Fiercely Consumed
Why did the CPU suddenly spike like this? After investigation, we found out that it was often due to the lack of strict logic in the question’s code.
Some questions (especially those requiring complex mathematical operations or multi-threaded processing) don’t have proper connection timeout and process release mechanisms in the background after the player establishes a connection or sends a payload. As a result, if a few hundred players connect simultaneously and attack, the backend will continuously fork new Python processes without normal recycling, draining the entire machine’s computing resources in just a few minutes. At this point, the network admin has to urgently log into the host and manually kill the deadlocked processes while coordinating with the question team to adjust the service configuration of the question.
3. Firefighting Scene (2): Pre-Event Question Testing Oversights and Port Mapping Anomalies
Another situation that causes chaos is “oversights in pre-event question testing.”
Due to the tight schedule, a few questions might only be tested for local connectivity during pre-event testing but fail to discover issues with the port mapping configuration or container startup script permissions, leading to the question not running properly after the event.
Within ten minutes of the event, the Discord ticket system starts receiving reports from users who can’t connect to the questions. At this point, we can only sigh and quickly log into the target machine to check the logs, find out which question’s port mapping is wrong or the container isn’t running, fix it and restart it, and then quietly close the ticket and reply “Fixed~” ww.
4. Firefighting Scene (3): Questions Being Taken Offline Unexpectedly and IP Blocking for Investigation
In the CTF arena, players’ ideas are always more adventurous than you can imagine. Sometimes certain questions are directly crashed (Crash) by the players’ unexpected payloads, even causing the entire Docker container of the question to go offline.
In such situations, the network admin’s work is not just simply restarting the container. We must immediately review the Nginx Access Log and container logs to analyze whether it was normal solving that caused the crash or if a player used an aggressive and delay-free automated script for brute-force scanning:
- Analyze Logs and Behavior Patterns: Filter out the characteristics of abnormal requests and attack paths.
- Investigate the Source IP: Confirm the source IP range of the malicious connection.
- Immediate Dynamic Blocking: Immediately issue blocking rules (IP Drop / Rate Limiting) on the Linux local IPTables to block malicious traffic at the door, ensuring that other rule-abiding players are not affected.
Post-Event Data Export and Summary
When the countdown reaches zero at the end of the competition, the players might finally be able to relax and get some sleep, but for the network admin team, the final stretch of the journey is just beginning.
1. Post-Event Data Export and CTFtime Score Export
Since THJCC has officially registered on the internationally renowned CTFtime competition platform this time, it means that we must produce official score data that meets the standards after the event, which will be submitted to the CTFtime official for weight calculation and global team score synchronization.
The network admin team mainly needs to handle the export of the following key data after the event:
- CTFtime Scoreboard Feed: Export a score list (Scoreboard JSON) in the CTFtime format from CTFd, including the team names, submission timestamps, final scores, and rankings, allowing the official to accurately update the scores.
- Complete Submission Logs: Export detailed records of all teams’ flag submissions (including correct and incorrect attempts, submission times, and source IPs), providing the question team and review team with the data to verify the writeups and check for any violations such as copying, flag sharing, or abnormal proxying.
- Database and Question Environment Backup: Make a complete backup of the entire competition’s CTFd database and all question settings, serving as a valuable database for future event reviews and club inheritance.
(Screenshot: CTFd backend export screen for CTFtime Scoreboard and submission logs)
2. Network Admin Lead Reflections and Summary
From the third THJCC, where I didn’t even know what had just happened and just “got through” as a rookie, to personally taking on the role of “Network Admin Team Leader” for the 2026 THJCC Summer Edition, this journey has been a valuable practical experience for me.
Honestly, as a network admin lead, your battlefield is not on the problem-solving ranking list, but in those unseen terminal windows, Nginx logs, and real-time indicators from btop. The heart-pounding moments of watching 8 CPU cores reach 100% and the Load Average surge to 166, the tense feeling of sweating cold while fixing port mapping, and the relief of seeing the platform withstand the full traffic and successfully complete the event—these behind-the-scenes joys and hardships are completely unattainable as a mere participant.
A successful CTF competition is not only about the players’ fierce battles and the question team’s meticulous design, but also about the indispensable cornerstone of a stable infrastructure behind the scenes.
Finally, I would like to specially thank the general coordinator for their trust and the cooperation of all team members. I also want to thank NCSE Network (ncse.tw) once again for the high-quality VPS servers and network resource support provided before and during the event, allowing this 2026 THJCC Summer Edition to conclude successfully!
2026 THJCC CTF サマーエディション:ネットワーク管理者長の実戦Writeup
2026 THJCC CTF Summer Edition | Network Team
Date: 2026/08/15
Role: CTF Network Admin Lead (ネットワーク管理者長)
はじめに
第3回THJCCのネットワーク管理者として参加した時、私は「一体何が起きたのか分からないまま大会が終わってしまったww」という曖昧な状態だった。まさか1年後、偶然の機会で「ネットワーク管理者長」という立場に就くことになるとは思わなかった。
本題に入る前に、簡単な自己紹介をさせていただきます。私はKaiyasiと申します。現在、中興大学応用数学科の1年生であり、SCAICT(中南部高校情報クラブ連合)の情報部長も務めています。私の趣味や学習の中心は、フルスタックウェブ開発、システムアーキテクチャの計画、そしてサイバーセキュリティ分野の実務的な探求にあります。
今回の大会が終了した後、総司会から課された大会後のタスクの一つとして、この非常に珍しい「Writeup」を書くことにしました。通常の問題解決中心のWriteupとは異なり、今回は運用とアーキテクチャの観点から、「CTFのネットワーク管理者という職務が実際に何をしているのか?」、「大会前・大会中・大会後にどのような大きな落とし穴や予期せぬ出来事に遭遇するのか?」、そして我々の裏方チームがどのようにしてネットワークとインフラストラクチャを安定して構築したのかについて、紹介したいと思います。
大会前の環境構築
1. 穷学生の救世主:国雲ネットワーク(NCSE Network)の感謝
実際に学生の大会やサークルイベントを運営したことがある人は、準備期間で最も頭を悩ませるのは出題とスポンサーの確保だけでなく、「サーバーとマシンはどこで用意するのか?」という点でもあることを知っています。すべてのサーバーを自費でクラウドに借りるなんて、貧乏学生が大会を開くには到底不可能です。
ここではまず、国雲ネットワーク(NCSE Network, ncse.tw) のコミュニティスポンサーシッププログラムに心から感謝したいと思います!今回の2026 THJCCサマーエディションが順調に環境を構築できたのは、国雲ネットワークの高性能VPSサーバーと安定した帯域の提供に大きく依存しています。ネットワークの品質、マシンの性能、技術的なサポートなど、背後で構築する際には非常に安心できました。もし手元に高校・大学の情報サークルやオープンソースプロジェクト、または同様の学生大会を運営している団体があるなら、ぜひこのコミュニティスポンサーシッププログラムを申請してみてください。学生チームにとって非常にありがたい存在です!
2. リソースの算出:スポンサーにどうリソースを依頼するか?
スポンサーの支援があるとはいえ、両手を挙げて「頂配で全部ください」とは言えません。ネットワーク管理者長として、大会前の最も重要な数学の問題は「リソースの見積もり」です。予想される規模に基づいて、合理的なハードウェアリストを算出する必要があります。私たちは以下のロジックでリソースを検討しました:
言い換えると:
- プラットフォームの基本盤:今回の大会にどのくらいのチームが参加するか?開会直後にどれだけの人がトップページを叩くか?これはCTFdプラットフォームのCPUコアとメモリの基本盤を決めます。
- 問題のハードウェアコスト:出題チームがどのくらいの問題を出しましたか?どの問題がメモリを大量に消費するWebサービスですか?どの問題が動的にコンテナを起動するPwn問題ですか?各問題に対してメモリとCPUの上限を事前に見積もります。
- トラブル防止のバッファ:エンジニアの鉄則は「リソースを正確に100%まで確保しないこと」です。20%から30%の余裕を確保して、開会時の予期せぬ流量やトラブルに備える必要があります。
しかし現実には、想像よりも厳しいのです—大会前の問題はまだ完成していません!
CTFを開催したことがある人なら、出題チームが締切直前に限界まで出題するのは常識中の常識です。私たちがスポンサーにリソースを申請する時点では、問題リストはまだ半分しか埋まっていません。問題の種類(どれだけのWeb/Pwn問題がリソースを消費するか、どれだけのMisc/Crypto問題が静的か)は完全に謎です。
このとき、ネットワーク管理者の「運の妙」が問われます。過去の大会の参加者数や出題規模を参考に、過去の経験をもとに合理的な範囲(Range Estimation)を推測する必要があります。
さらに良いことに、国雲ネットワークのコミュニティスポンサーシッププログラムは非常に柔軟で、最初からリソース仕様を完全に決めなくても構いません!
これはネットワーク管理者にとって非常にありがたいです。私たちの対応策は:最初はリソースを控えめに申請して、基本盤のプラットフォームとコアのターゲットを安定して動かす。大会直前、出題チームが問題を次々に提出した後、ある問題が特にリソースを大量に消費しているか、メモリが足りないことが分かった場合は、追加のリソースと柔軟な拡張を即座に国雲ネットワークに申請します。これにより、スポンサーのリソースを無駄にすることなく、ネットワーク管理者がリソース仕様を予測するストレスを大幅に軽減できます。
3. アーキテクチャの大禁:なぜ一台のマシンで済ませてはいけないのか?(CTFdとターゲットマシンの分離の哲学)
アーキテクチャを検討する会議で、たまに「CTFdとDocker問題をすべて一台のマシンに詰め込んでしまえば、集中管理が楽でしょ?」という声が上がるかもしれません。
このような考えに出会ったとき、私は「まずやめなさい、本当に大変なことになります!」としか言えません。
今回の大会では、アーキテクチャを「CTFdプラットフォームマシン」と「問題のターゲットマシン」の2台の独立したサーバーに厳密に分離しました。その背景には以下の2つの大きな理由があります:
-
爆破の隔離と防爆(リソースの保護):
CTFの参加者がどれほど激しいかは誰もが知っています。問題を解く際に、Pythonスクリプトを多スレッドで爆破したり、さまざまな悪意のあるペイロードを送信したり、無限ループを作り出すことは日常茶飯事です。CTFdとターゲットマシンを同じマシンに詰め込むと、ある問題が参加者によってメモリオーバーフロー(OOM)やCPUが100%に達すると、サーバーがフリーズしてCTFdプラットフォームは直接502 Bad Gatewayを返します。その結果、すべての参加者がFlagを提出できず、Discordのチャンネルは5秒以内に「プラットフォームが落ちた!」という悲鳴で埋め尽くされ、その様子を想像するだけで胃が痛くなります。 -
セキュリティリスクと内網の隔離(権限の保護):
本来、ターゲットマシンにはさまざまな意図的な穴が存在し、多くの問題がRCE(リモートコード実行)をターゲットとしています。もしCTFdとターゲットマシンが同じマシンで動いていたら、ある問題のコンテナが参加者によって完全に破壊され、権限の昇格に成功した場合、攻撃者はDocker内のネットワークをチェックし、隣接するCTFdのデータベースとすべての問題のFlagを一括で奪い去ることになります。その結果、この大会は全員が失格となることになります。
したがって、スコアボードとターゲットマシンを物理的・仮想的に分離することは、ネットワーク管理者が安心して眠れるための最初の保険です。
4. 自分たちの特徴を出す:CTFd専用テーマとビジュアルデザイン
ほぼすべてのCTF大会はCTFdというオープンソースプラットフォームをベースにしていますが、正直に言って、すべての大会が同じように見えてしまうと、何かが欠けているように感じます。
それぞれの大会には独自のビジュアルと雰囲気があります。参加者に最初から没入感を与えるために、私たちはCTFdのカスタムテーマ(Custom Theme)開発に多くの時間を費やしました。深く現代的なカラーパレット、トップページの大会規則と賞金カードの表示、チャレンジボード(Challenge Board)の分類フィルターと問題カードのレイアウトを含め、大会が安定しているだけでなく、THJCC独自のテクノロジー感を備えた視覚体験を提供しました!
5. CTFdの設定でよくある落とし穴
マシンを起動した後、次はCTFdのデプロイです。公式にはDocker Composeが用意されていますが、実際の生産環境で何百人ものユーザーが利用する際には、いくつかの落とし穴があります。
- Nginxの逆プロキシとリミット(リミット保護):
これは非常に重要です!Nginxにリミット設定がなければ、開会後5分以内にNginxログが瀑布のように流れ、サーバーは参加者の自動スキャンスクリプトで即座にダウンします。ログインやFlagの提出APIエンドポイントに適切なリクエストレートリミットを設定する必要があります。 - Redisキャッシュとセッション管理:
強く推奨するのはRedisの導入です。開会直後、誰もが問題リストを頻繁にリロードするため、毎回MySQLデータベースに直接アクセスすると、データベース接続プールが一瞬で満杯になります。Redisが熱門データのキャッシュとセッションを担当することで、全体の反応速度が非常に向上します。 - Cloudflare CDN保護:
最外層にCloudflareを導入することで、静的リソース(CSS、JS、画像)の流量を大部分をカバーし、一部の基本的なスキャンや小規模な流量の衝撃を防ぐことができます。 - 動的問題のコンテナライフサイクル管理:
この大会で「チームごとに実体」の動的問題を出題した場合、自動タイムアウト回収メカニズム(Auto Clean-up)が正常に動作していることを確認する必要があります。そうでなければ、テスト中にコンテナを起動して閉じていない場合、本番開催前にハードディスクとメモリがすべての死んだ幽霊コンテナに消費され、新しい問題を起動するスペースすらなくなることになります。
大会中の問題対応と緊急対応現場
開会の合図が鳴ると、ネットワーク管理者チームの「胃痛の時間」が始まります。事前テストがどれほど完璧でも、開会後には予想外のトラブルが常に待ち構えています。
1. 監視の神器登場:血圧が上昇するbtop実録
大会中のネットワーク管理者の端末にはほぼ常に**btop**(btop++)が常駐しています。このC++ベースの端末リソース監視ツールは画面が美しいだけでなく、各指標の更新も非常にリアルタイムで、主機の健康状態を常に把握するための絶対的な神器です。
ただ、以下の画面を見たとき、あなたの心拍数もCPUと一緒に天井を突き破るかもしれません:
はい、これが私たちは大会中に実際にキャプチャした「災難現場」です—8コアのCPUがすべて100%満杯になり、赤く染まり、Load Averageは驚くほど166にまで上がっています! スケジュールリストには、すべてのCrypto問題のPythonとGunicornの処理が詰まっています。この数字を見た瞬間、手のひらから汗が出るほどです。
2. 緊急対応(その1):問題自体のコードが「漏れ」、リソースが激しく消費される
なぜCPUが急激に上がったのか?調査した結果、これは出題時のコードロジックが不完全だったためです。
一部の問題(特に複雑な数学演算やマルチスレッド処理が必要な問題)では、参加者が接続を確立したりペイロードを送信した後、接続タイムアウトやプロセスの解放の仕組みがしっかり設計されていません。その結果、数百人の参加者が同時に接続すると、後ろで新しいPythonプロセスをフォークし続けるが、正しく終了しないため、数分でマシンの計算リソースを完全に使い果たしてしまいます。このとき、ネットワーク管理者は緊急でマシンにログインして、フリーズしたプロセスを手動でkillする一方で、出題チームと協議して問題のサービス設定を調整する必要があります。
3. 緊急対応(その2):大会前の問題テストの欠陥とポートマッピングの不思議な出来事
もう一つの手が回らない状況は「大会前の問題テストの欠陥」です。
出題時間が限られているため、一部の問題は大会前テスト時にローカル接続性だけをテストしただけで、外部のポートマッピングの設定ミスや、コンテナ起動スクリプトの権限不足により、大会後に正常にListenしないことが発覚する場合があります。
大会開始後10分もたたないうちに、DiscordのTicketシステムに連絡が入って問題に接続できないと報告されるようになりました。そのときには、仕方なくターゲットマシンにログインしてログを確認し、どの問題のポートマッピングが間違っていたか、またはコンテナが起動していないかを確認し、すぐに修正して再起動し、Ticketを閉じて「修復しました~」と返信するしかありません。
4. 緊急対応(その3):問題が予期せぬ方法でダウンし、IPアドレスの逆引きとブロック
CTFの大会では、参加者の発想は常にあなたの予想を超えてきます。ときには、ある問題が参加者の予期せぬペイロードによって直接クラッシュ(Crash)してしまうこともあります。その結果、その問題のDockerコンテナが完全に停止してしまいます。
このような状況では、ネットワーク管理者の仕事は単にコンテナを再起動するだけではありません。Nginx Access Logとコンテナのログをすぐに確認し、正規の問題解決で破壊されたのか、または参加者が過激で遅延のない自動スキャンスクリプトを使用して攻撃しているのかを分析する必要があります:
- ログと行動パターンの分析:異常な大量リクエストの特徴と攻撃経路をフィルタリングする。
- 送信元IPの逆引き:悪意のある接続の送信元IPネットワークを確認する。
- 即時の動的ブロック:LinuxのローカルIPTablesでブロック規則(IP Drop / レートリミット)を即座に実行し、悪意のあるトラフィックを門の外に遮断し、他のルールを守る参加者に影響を与えないようにする。
大会後のデータエクスポートと総括
大会終了のカウントダウンがゼロになるその瞬間、参加者たちは一息ついて眠りにつくかもしれませんが、ネットワーク管理者チームにとって最後の1マイルの終了作業が始まります。
1. 大会後のデータエクスポートとCTFtime成績のエクスポート
THJCCはこの大会を国際的に知られるCTFtime大会プラットフォームに正式登録したため、大会後に公式の成績データを出力し、CTFtime公式に提出して、世界中のチームのポイントの調整を行う必要があります。
ネットワーク管理者チームが大会後に主に処理する重要なデータのエクスポートは以下の通りです:
- CTFtimeスコアボードFeed:CTFdからCTFtime形式のスコアボード(Scoreboard JSON)をエクスポートし、チーム名、問題解決のタイムスタンプ、最終スコア、順位などを含め、公式がポイントを正確に更新できるようにします。
- 完全な提出ログ(Submission Logs):すべてのチームがFlagを提出した詳細な記録(正解・不正解の試行、提出時間、送信元IP)をエクスポートし、出題チームと審査チームがWriteupを確認し、不正行為(模範解答の共有、Flagの共有、異常な代行など)をチェックするための資料として提供します。
- データベースと問題環境の保存:大会のCTFdデータベースと各問題の設定を完全にバックアップし、今後の大会の振り返りやサークルの継承に貴重な資料として保存します。
(スクリーンショット:CTFdのバックエンドからCTFtimeスコアボードと提出ログをエクスポートする画面)
2. ネットワーク管理者長の感想と総括
第3回の大会では、何が起きたのか分からないまま、無作為に「乗り切った」初心者スタッフから、今回の2026 THJCCサマーエディションでネットワーク管理者長を務めることになった私の経験は、非常に価値のある実戦経験でした。
正直に言って、ネットワーク管理者長として、あなたの戦場はスコアボードの問題解決ランキングにはありません。あなたの戦場は、見えないターミナルウィンドウ、Nginxログ、そしてbtopのリアルタイム指標の中にあります。8コアのCPUが100%に達し、Load Averageが166にまで上がるような心臓の高鳴り、Discordで冷や汗をかきながらポートマッピングを直す緊張感、そしてすべてのトラフィックを耐えて大会が無事に終了したときの安心感—これらの裏方の酸甜苦辣は、単純に参加者としての経験では到底体験できないものです。
成功したCTF大会には、参加者の神業的な戦いと出題チームの丁寧な設計だけでなく、裏方で安定したインフラストラクチャが不可欠な基盤です。
最後に、総司会の信頼と各チームの協力に感謝し、特に国雲ネットワーク(NCSE Network) の大会前および大会中の高品質なVPSサーバーとネットワークリソースの支援に改めて感謝します。今回の2026 THJCCサマーエディションが無事に終了できたのは、すべて彼らのおかげです!
2026 THJCC CTF Summer Edition: 네트워크 관리자 실전 Writeup
2026 THJCC CTF Summer Edition | Network Team
Date: 2026/08/15
Role: CTF Network Admin Lead (네트워크 관리자 팀장)
서론
세 번째 THJCC 네트워크 팀을 마무리하면서, 내가 완전히 “아직도 무슨 일이 일어났는지 모르겠다”는 상태로 대회가 끝났던 기억이 난다. 한 해가 지나고, 기회가 되어 이번에는 네트워크 팀장이라는 중책을 맡게 되었다.
정식으로 본론에 들어가기 전에 간단한 자기소개를 해보자. 나는 Kaiyasi이며, 현재 중흥대학교 응용수학과 1학년 학생이며, SCAICT(중남부 고등학교 정보 동아리 연합)의 정보 부문장을 맡고 있다. 평소 관심과 학습 중심은 전체 웹 개발, 시스템 아키텍처 계획, 그리고 보안 분야의 실무 탐색에 집중되어 있다.
이번 대회가 끝난 후, 총무의 지시로 후속 작업을 맡게 되었고, 일반적인 해설 위주가 아닌 “Writeup”을 작성하기로 결정했다. 일반적인 문제 풀이 중심의 Writeup과는 달리, 이 글은 운영 및 아키텍처 관점에서 “CTF 네트워크 관리자는 어떤 일을 하는가?” “대회 전, 중, 후에 어떤 큰 문제와 예기치 못한 상황을 마주쳤는가?” 그리고 우리가 뒷받침한 대회 네트워크 및 인프라가 어떻게 안정적으로 운영되었는지를 이야기하고자 한다.
대회 전 환경 설정
1. 가난한 학생의 구원: 국운네트워크 (NCSE Network)
정말 솔직하게 말하면, 학생 대회나 동아리 활동을 해본 사람이라면 모두 알고 있다. 대회 준비 시 가장 힘든 일 중 하나는 “서버와 기계를 어디서 뽑을까?”하는 문제이다. 모든 서버를 자체적으로 공유 클라우드를 빌려야 한다면, 가난한 학생은 대회 후 길가에 앉아 먹을 것조차 없을 수도 있다.
이 부분에서 먼저 국운네트워크 (NCSE Network, ncse.tw) 의 커뮤니티 후원 프로그램에 감사를 드리고 싶다. 이번 2026 THJCC 여름 대회가 성공적으로 환경을 구축할 수 있었던 것은 국운네트워크의 후원으로 가능했다. 고성능 VPS 서버와 안정적인 대역폭 자원을 제공해 주었기 때문에, 네트워크 연결 품질, 서버 성능, 기술 지원 등에서 많은 안도감을 느꼈다. 만약 여러분의 주변에 고등학교/대학 정보 동아리, 오픈소스 프로젝트, 또는 유사한 학생 대회를 준비 중이라면, 정말로 이 후원 프로그램을 추천한다. 학생 팀에게는 정말 큰 도움이 될 것이다!
2. 계산 시간: 후원사에게 자원을 요청하는 방법
후원사의 지원이 있더라도, 두 손을 들고 “최고 사양을 주세요”라고 말할 수는 없다. 네트워크 팀장으로서 대회 전에 가장 중요한 수학 문제는 “자원 계산”이다. 예상 규모에 따라 합리적인 하드웨어 목록을 계산해야 한다. 우리는 일반적으로 아래와 같은 논리를 사용하여 자원을 확보했다.
간단하게 말하면:
- 플랫폼 기본 기반: 이번 대회에 몇 팀이 참가할지 예상한다. 개회 순간에 몇 명이 홈페이지를 퍼블릭하게 클릭할지 결정한다. 이는 CTFd 플랫폼의 CPU 코어와 메모리 기본 기반을 결정한다.
- 문제 하드웨어 소모: 문제 팀이 몇 문제를 내는지, 어떤 문제는 메모리 소비가 많은 웹 서비스인가? 어떤 문제는 동적 컨테이너를 생성하는 Pwn 문제인가? 각 문제에 대해 메모리와 CPU 상한선을 예측해야 한다.
- 문제 발생 방지용 여유 공간: 엔지니어의 철칙은 “절대 자원을 정확히 100%까지 확보하지 않는다.” 20%에서 30%의 여유 공간을 확보하여, 대회 시작 시 예상치 못한 트래픽과 긴급 상황에 대비해야 한다.
하지만 현실은 상상보다 더 뼈아프다. 대회 전 문제는 완전히 준비되지 않았다. CTF를 개최한 경험이 있는 사람이라면, 문제 팀이 마감일 직전에 극한으로 문제를 제출하는 것이 일반적인 상황이라는 것을 잘 알고 있다. 우리가 후원사에게 요청해야 하는 시점에는 문제 목록이 반만 채워져 있고, 문제 유형 비율(어떤 문제가 자원을 많이 소모하는 웹/Pwn 문제인지, 어떤 문제가 순수한 정적 문제인 Misc/Crypto인지)은 여전히 미스터리였다.
이 시점에서는 네트워크 관리자의 “玄學 경험”이 매우 중요하다. 우리는 과거 몇 번의 대회 참가 인원과 문제 규모를 참고하여, 합리적인 범위를 추정하는 “범위 추정”을 해야 했다.
더 나은 점은 국운네트워크의 커뮤니티 후원 프로그램은 처음에 자원 규격을 완전히 정해 놓을 필요가 없다는 점이다. 이는 네트워크 관리자에게는 구원이었다. 우리의 대응 전략은: 처음에는 보수적으로 자원을 요청하고, 기본 플랫폼과 핵심 문제 기반을 안정적으로 운영하도록 했다. 대회 일정이 가까워지고, 문제 팀이 문제를 점차 제출할 때, 특정 문제가 자원을 많이 소비하거나 메모리가 부족한 경우, 즉시 국운네트워크에게 추가 할당과 유연한 확장을 요청했다. 이는 후원사 자원을 낭비하지 않고, 네트워크 관리자가 대회 전에 자원 규격을 예측하는 심리적 부담을 크게 줄였다.
3. 아키텍처의 금기: 왜 단일 서버는 절대 사용할 수 없는가? (CTFd와 타겟 기계의 분리 철학)
아키텍처를 논의할 때, 가끔 누군가가 말한다. “CTFd와 Docker 문제를 모두 한 대의 최고 사양 서버에 넣으면 안 되는가? 중앙 집중 관리는 정말 편리하지 않겠는가?”
이러한 생각을 들었을 때, 나는 단호하게 말한다: “아니, 절대 안 된다. 정말 큰 문제가 생길 수 있다.”
이번에는 아키텍처를 엄격하게 “CTFd 플랫폼 서버”와 “문제 타겟 서버”로 두 대의 독립적인 서버로 분리했다. 그 이유는 두 가지 중요한 경험 때문이다:
-
폭파 격리 및 방어 (자원 보호):
CTF 참가자들이 얼마나 무자비한지 모두 알고 있다. 문제 풀이 중에 Python 스크립트를 다중 스레드로 폭파하거나, 다양한 악성 페이로드를 전송하거나, 무한 루프를 만들기도 흔하다. CTFd와 타겟 기계를 한 개의 서버에 넣는다면, 어떤 문제를 참가자가 OOM(메모리 오버플로우)나 CPU가 100%로 올라가게 하면 서버가 멈추고, CTFd 플랫폼은502 Bad Gateway를 발생시킬 수 있다. 이 경우, 모든 참가자는 플래그를 제출할 수 없고, Discord 채널은 5초 이내로 “플랫폼이 다운됐다!”는 절규로 가득 찰 것이다. 이 장면만으로도 배가 아프다. -
보안 위험과 내부 네트워크 격리 (권한 보호):
타겟 기계에는 다양한 의도적인 취약점이 존재하며, 많은 문제는 RCE(원격 코드 실행)를 목표로 하고 있다. 만약 두 가지를 공유하는 서버라면, 어떤 문제의 컨테이너가 참가자에 의해 완전히 파괴되거나, 권한 상승이 성공한다면, 공격자는 Docker 내부 네트워크를 탐색하여 CTFd의 데이터베이스와 모든 문제의 플래그를 한 번에 빼앗을 수 있다. 이 경우, 대회는 단번에 종료될 수 있다.
이처럼, 스코어보드와 타겟 기계를 물리적/가상으로 분리하는 것은 네트워크 관리자가 편안하게 자는 첫 번째 보장이다.
4. 자신의 특징을 만드는 것: CTFd 전용 테마와 시각 디자인
대부분의 CTF 대회는 CTFd라는 오픈소스 플랫폼을 기반으로 운영된다. 하지만 솔직히 말하면, 매번 열리는 대회가 모두 비슷하게 보이면, 뭔가 영혼이 부족하다는 생각이 든다.
각 대회는 자신의 주요 시각과 톤을 가지고 있어야 한다. 참가자들이 로그인한 순간부터 몰입감을 줄 수 있도록, 우리는 CTFd를 위한 맞춤형 테마(Custom Theme) 개발에 많은 시간을 할애했다. 대회 전용의 어두운 현대적인 색상, 첫 화면의 대회 규칙 및 상금 카드 표시, 챌린지 보드(Challenge Board)의 분류 필터 및 문제 카드 레이아웃을 통해, 이 대회는 안정적이면서도 THJCC만의 독특한 기술적인 감성을 가지고 있다!
5. CTFd 설정 시 주의할 점들
서버를 켜고 나서, 다음으로 CTFd를 배포해야 한다. 공식적으로 제공하는 Docker Compose를 사용하면 쉽게 시작할 수 있지만, 실제로 수백 명이 사용하는 생산 환경에서는 몇 가지 주의할 점이 있다.
- Nginx 역방향 프록시 및 요청 제한 설정 (Rate Limiting):
이건 가장 중요한 부분이다! Nginx에 요청 제한 설정이 없으면, 대회 시작 5분 이내에 Nginx 로그가 폭포처럼 쏟아질 것이며, 서버는 참가자의 자동화된 스크립트에 의해 즉시 정지될 수 있다. 반드시 로그인 및 플래그 제출 API 엔드포인트에 적절한 요청 속도 제한을 설정해야 한다. - Redis 캐시 및 세션 관리:
Redis를 반드시 사용하는 것을 추천한다. 대회 시작 순간, 모두가 문제 목록을 계속 새로고침하려고 하기 때문에, 각 요청이 MySQL 데이터베이스에 직접 접근하면 데이터베이스 연결 풀이 즉시 가득 차게 된다. Redis가 인기 있는 데이터 캐시 및 세션을 처리해 주면, 전체 반응 속도가 훨씬 원활해진다. - Cloudflare CDN 보호:
외부에 Cloudflare를 적용하면, 대부분의 정적 리소스(CSS, JS, 이미지) 트래픽을 처리할 수 있을 뿐만 아니라, 일부 기본적인 스캔 및 소규모 트래픽 공격을 차단할 수 있다. - 동적 문제의 컨테이너 수명 주기 관리:
이번에 “팀당 하나”의 동적 문제를 출제했다면, 자동 타임아웃 회수 기능(Auto Clean-up)이 정상적으로 작동하는지 확인해야 한다. 그렇지 않으면, 테스트 시 열린 컨테이너를 닫지 않으면, 대회 시작 전에 하드디스크와 메모리가 이미 많은 죽은 유령 컨테이너에 의해 완전히 소진되어, 새로운 문제를 시작할 공간이 없을 수 있다.
대회 중 문제 처리 및 대응 현장
대회 시작 소리가 울리자, 네트워크 팀의 “배고픔 시기”가 정식으로 시작되었다. 대회 전에 완벽하게 테스트했더라도, 대회 후에는 항상 예상치 못한 다양한 긴급 상황이 기다리고 있다.
1. 모니터링 도구 등장: 혈압이 치솟는 btop 실황
대회 중 전반적으로 네트워크 팀의 터미널에는 거의 항상 btop (btop++)가 열려 있다. 이 C++ 기반의 터미널 리소스 모니터링 도구는 화면이 아름다우며, 모든 지표가 매우 실시간으로 업데이트되어, 서버의 건강 상태를 항상 파악할 수 있는 절대적인 도구이다.
그러나 아래와 같은 화면을 보면, 심장 박동이 CPU와 함께 하늘로 치솟을 것이다:
맞다. 이건 우리가 대회 중에 실제로 포착한 “재난 현장”이다. 정말 8개의 CPU 코어가 모두 100%로 채워졌고, 빨갛게 물들어, Load Average는 놀랄 만한 166까지 올라갔다. 작업 목록에는 암호화 문제의 Python과 Gunicorn 계산 작업이 가득 차 있었다. 이 숫자를 보았을 때, 손바닥에 땀이 흘렀다.
2. 대응 현장 (1): 문제 자체의 코드 “유출”로 인한 자원 과도 사용
왜 CPU가 갑자기 이렇게 올라갔을까? 조사해 보니, 이는 문제 팀이 프로그래밍 논리가 충분히 엄격하지 않았기 때문이다.
일부 문제(특히 복잡한 수학 연산이나 다중 스레드 처리가 필요한 문제)는 참가자가 연결을 설정하거나 페이로드를 전송한 후, 백그라운드에 연결 타임아웃 및 프로세스 해제 메커니즘을 설계하지 않았다. 결과적으로 몇백 명의 참가자가 동시에 연결되면, 백엔드는 계속 새로운 Python 프로세스를 포크하지만 정상적으로 종료하지 않아, 몇 분 안에 서버의 계산 자원을 완전히 소모하게 된다. 이때 네트워크 팀은 즉시 서버에 로그인하여 죽은 프로세스를 수동으로 kill해야 하며, 문제 팀과 협의하여 문제 서비스 설정을 조정해야 한다.
3. 대응 현장 (2): 대회 전 문제 검증 누락 및 포트 매핑 기이한 사건
또 다른 혼란스러운 상황은 “대회 전 문제 검증 누락”이었다.
출제 시간이 급한 탓에, 일부 문제는 대회 전 문제 검증 시 로컬 연결성을만 테스트했을 뿐, 외부 포트 매핑 설정이 잘못되었거나, 컨테이너 시작 스크립트 권한이 부족해 대회 후 정상적으로 Listen하지 못하는 경우가 있었다.
대회 시작 후 10분 이내, Discord의 Ticket 시스템에 연락이 계속 들어왔다. “문제에 연결할 수 없습니다.” 이때는 손을 들어서 즉시 타겟 서버에 로그인하여 로그를 확인해야 했으며, 어떤 문제의 포트 매핑이 잘못되었거나 컨테이너가 정상적으로 실행되지 않았는지 확인하고, 즉시 수정 및 재시작한 후, Ticket을 닫고 “수정 완료~“라고 응답했다.
4. 대응 현장 (3): 문제를 예상치 못한 방식으로 다운 및 IP 차단 조사
CTF 대회장에서 참가자의 사고는 항상 당신의 예상보다 더 자유로운 경우가 많다. 가끔 어떤 문제는 참가자의 예상치 못한 페이로드로 인해 직접 충돌(崩潰)하게 되며, 때로는 Docker 컨테이너가 완전히 중단되기도 한다.
이런 상황에서는 네트워크 팀의 업무가 단순히 컨테이너를 재시작하는 것 이상이어야 한다. 즉시 Nginx Access Log와 컨테이너 로그를 조사하여, 정상적인 문제 풀이로 인한 충돌인지, 아니면 참가자가 너무 적극적인 자동화 스크립트를 사용하여 폭력적인 스캔을 수행하는지 분석해야 한다.
- 로그 및 행동 패턴 분석: 비정상적인 요청 특징과 공격 경로를 필터링하여 분석한다.
- 원본 IP 반추: 악성 연결의 원본 IP 네트워크를 확인한다.
- 즉시 동적 차단: 즉시 Linux 로컬의 IPTables에 차단 규칙을 실행(IP Drop / Rate Limiting)하여 악성 트래픽을 문 밖으로 차단하고, 다른 규칙을 지키는 참가자들이 영향을 받지 않도록 한다.
대회 후 데이터 추출 및 정리
대회 종료 카운트다운이 0이 되는 순간, 모든 참가자는 잠을 자기 위해 편안해질 수 있지만, 네트워크 팀에게는 마지막 1마일의 마무리 작업이 시작된다.
1. 대회 후 데이터 추출 및 CTFtime 성적 추출
이번 THJCC는 국제적으로 유명한 CTFtime 대회 플랫폼에 공식적으로 등록되어 있기 때문에, 대회 후에는 규격에 맞는 공식 성적 데이터를 생성하여 CTFtime 공식 사이트에 제출해야 한다. 이는 전 세계 팀의 점수를 계산하고 동기화하는 데 사용된다.
네트워크 팀이 대회 후 주로 처리하는 주요 데이터는 다음과 같다:
- CTFtime 점수 순위 Feed: CTFd에서 CTFtime 형식의 점수 순위를 추출(점수 순위 JSON), 팀 이름, 문제 해결 시간, 최종 점수 및 등수를 포함하여, 공식적으로 점수를 업데이트할 수 있도록 한다.
- 완전한 제출 로그(Submission Logs): 모든 팀이 제출한 플래그의 상세 기록을 추출(정확한 시도, 오류 시도, 제출 시간 및 원본 IP), 문제 팀 및 검토 팀이 Writeup을 검토하고, 표절, 플래그 공유 또는 비정상적인 대리 출전과 같은 위반 행위를 확인하기 위해 제공한다.
- 데이터베이스 및 문제 환경 보존: 전체 대회 CTFd 데이터베이스 및 문제 설정을 완전히 백업하여, 미래 대회 재검토 및 동아리 전승을 위한 소중한 데이터베이스로 활용한다.
(이미지: CTFd 백엔드에서 CTFtime 점수 순위 및 제출 로그를 추출하는 화면)
2. 네트워크 팀장의 경험 및 정리
세 번째 대회에서는 무슨 일이 일어났는지 모르고, 어리숙하게 “지나쳤던” 신입 팀원에서, 이번 2026 THJCC 여름 대회에서 네트워크 팀장으로 직접 임명된 이 여정은 나에게 매우 가치 있는 실전 경험을 제공했다.
솔직히 말해서, 네트워크 팀장으로서 전장은 문제 풀이 순위표가 아닌, 보이지 않는 터미널 창, Nginx 로그 및 btop의 실시간 지표에 있다. 8개의 CPU가 100%로 올라가고 Load Average가 166으로 치솟는 심장이 뛰는 순간, Discord에서 냉한을 흘리며 포트 매핑을 수정하는 긴장감, 그리고 마지막으로 플랫폼이 전체 트래픽을 견뎌내고 성공적으로 마무리하는 순간의 해방감 - 이러한 뒷받침의 쓰라린 감정은 단순히 참가자로 있을 때는 전혀 경험할 수 없었다.
성공적인 CTF 대회는 참가자들의 신의 경쟁과 문제 팀의 정성된 설계뿐만 아니라, 뒷받침하는 안정적인 인프라가 없으면 불가능한 기반이다.
마지막으로, 총무의 신뢰와 각 팀원들의 협력에 감사를 드리며, 다시 한 번 **국운네트워크 (NCSE Network)**에게 대회 전과 중에 제공한 고품질의 VPS 서버와 네트워크 자원 지원에 감사를 드린다. 이로 인해 2026 THJCC 여름 대회는 성공적으로 마무리할 수 있었다!
正在整理紙條…